
Mengapa SLM Mendorong Peralihan ke Edge AI
SLM mendorong Edge AI dengan memproses tugas rutin secara lokal, menekan latensi dan perpindahan data, tetapi tetap membutuhkan cloud untuk pekerjaan kompleks, pembaruan pengetahuan, dan pengawasan.

Ketergantungan pada cloud mulai menghadapi batas yang jelas ketika kecerdasan buatan harus bekerja dekat dengan pengguna, mesin, dan sensor. Model bahasa berukuran kecil atau Small Language Models (SLM) menawarkan pendekatan berbeda: sebagian kemampuan pemahaman dan generasi bahasa dipindahkan ke perangkat, bukan selalu dikirim ke pusat data. Perubahan ini bukan berarti cloud akan ditinggalkan, melainkan pembagian kerja antara perangkat lokal dan cloud mulai dirancang ulang.
Latensi dan biaya membuat pemrosesan lokal lebih masuk akal
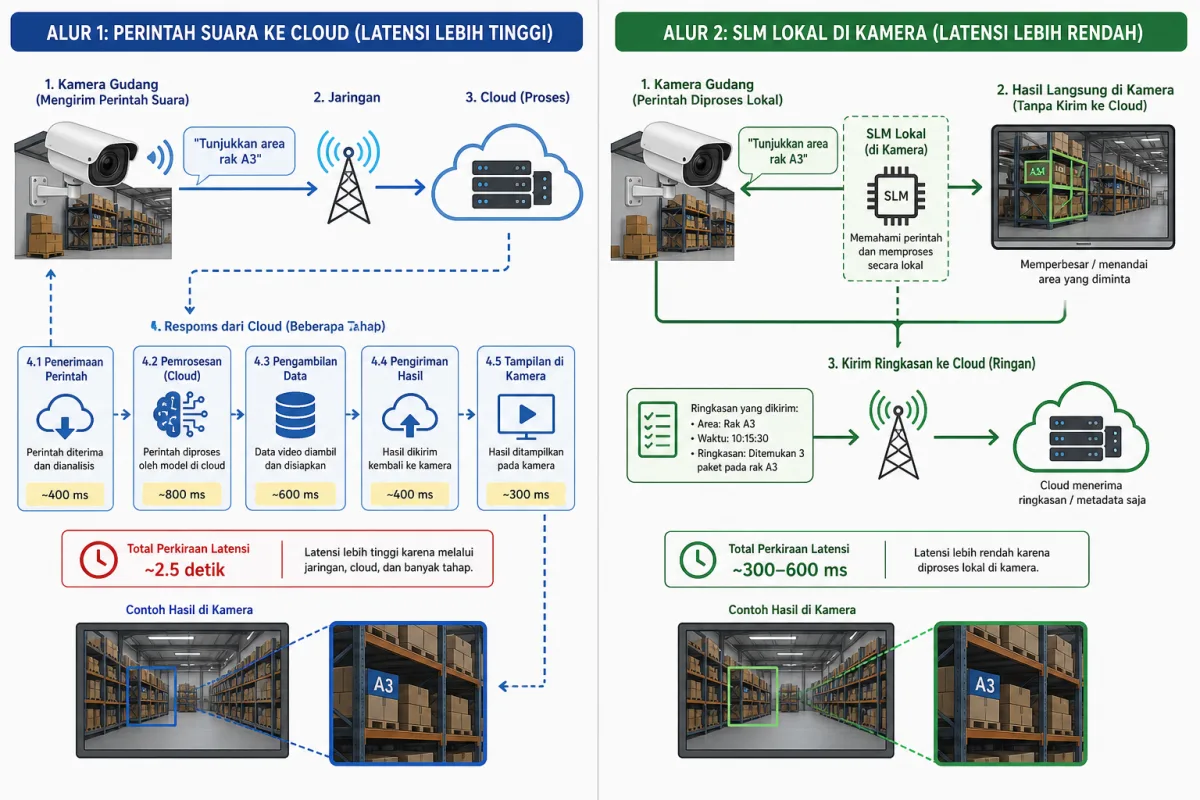
Alasan pertama SLM mendapat perhatian adalah kemampuannya mengurangi jarak antara permintaan pengguna dan respons AI. Pada arsitektur berbasis cloud, data perlu dikumpulkan perangkat, dikirim melalui jaringan, diproses server, lalu dikembalikan. Setiap tahap menambah waktu tunggu dan memakai bandwidth. Jika tugasnya sederhana, pengiriman ke cloud dapat menjadi proses yang lebih mahal dan lambat daripada menjalankan model kecil langsung di perangkat.
SLM bekerja dengan jumlah parameter, kebutuhan memori, dan beban komputasi yang lebih rendah dibandingkan model bahasa berukuran besar. Ukuran tersebut memungkinkan model dikompresi atau dijalankan menggunakan chip yang tersedia pada ponsel, komputer, kamera, kendaraan, atau perangkat industri. Teknik seperti kuantisasi dapat mengurangi presisi angka yang digunakan model agar konsumsi memori turun, sementara optimasi perangkat lunak membantu memanfaatkan prosesor khusus untuk AI. Konsekuensinya, perangkat dapat menyelesaikan tugas berulang tanpa mengirim seluruh data ke server.
Bayangkan kamera pengawas di gudang yang perlu mengenali perintah suara untuk memperbesar gambar, menandai area tertentu, atau membuat catatan singkat tentang kejadian. Jika setiap perintah harus dikirim ke cloud, respons bergantung pada kualitas koneksi dan antrean server. Dengan SLM di perangkat, perintah sederhana dapat ditafsirkan di lokasi, lalu kamera segera menjalankan tindakan. Cloud tetap dapat menerima ringkasan atau rekaman terpilih untuk analisis lanjutan.
Model lokal juga dapat menekan biaya operasional ketika jumlah permintaan bertambah. Setiap permintaan yang dikirim ke layanan cloud biasanya memakai sumber daya komputasi dan lalu lintas data. Penghematan tidak otomatis terjadi karena perangkat edge memerlukan chip, pembaruan perangkat lunak, penyimpanan, dan pemeliharaan. Namun, untuk tugas yang sering dilakukan dan pola jawabannya terbatas, biaya memindahkan pemrosesan ke perangkat dapat lebih rasional.
Batasnya terletak pada kompleksitas tugas. SLM mungkin memadai untuk klasifikasi, ekstraksi informasi, perintah suara, atau jawaban berdasarkan dokumen yang telah dipasang. Model ini belum tentu mampu menangani penalaran panjang, pengetahuan luas, konteks besar, atau permintaan yang berubah cepat. Jika perangkat memakai baterai kecil, prosesor lemah, atau harus melayani banyak pengguna sekaligus, pemrosesan lokal juga dapat menguras energi dan memperlambat fungsi utama perangkat. Karena itu, manfaat latensi dan biaya perlu dinilai dari jenis tugas, frekuensi penggunaan, kemampuan perangkat, serta kualitas koneksi yang tersedia.
Privasi meningkat, tetapi pengelolaan data tetap menentukan
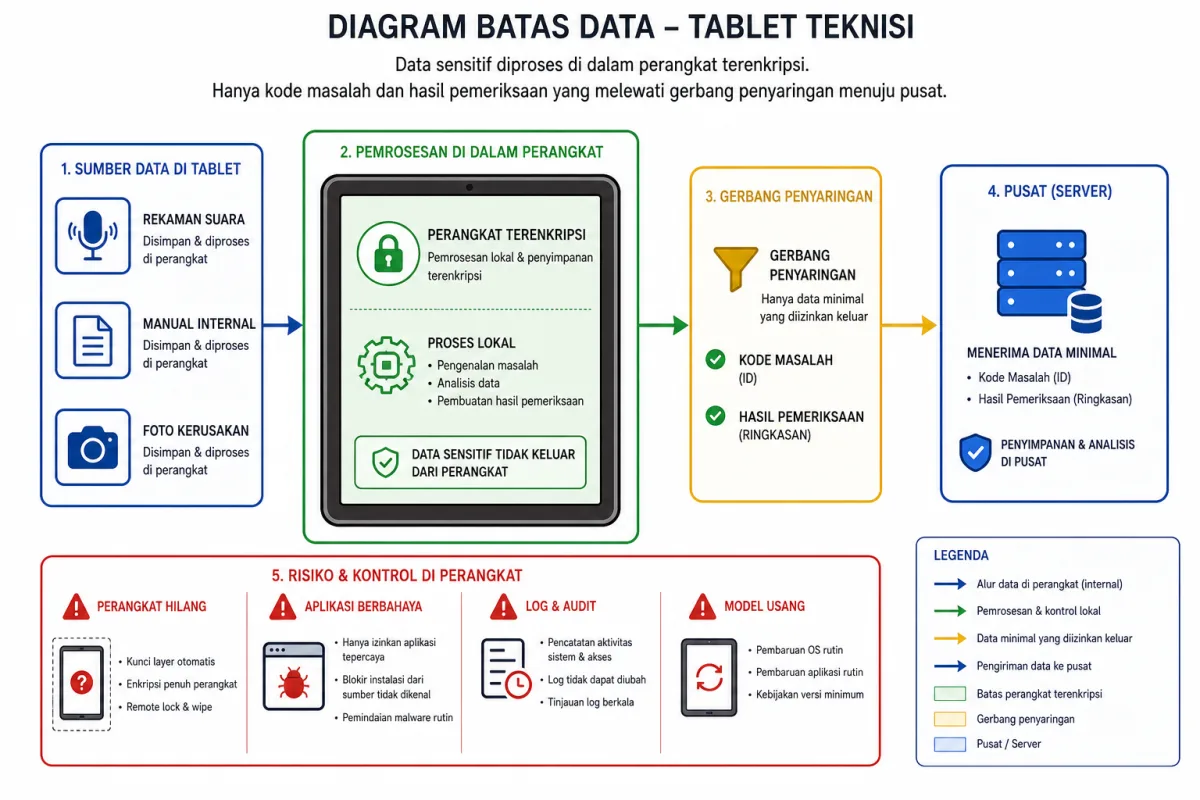
SLM dapat memperkuat privasi karena data sensitif tidak selalu perlu meninggalkan perangkat. Mekanismenya sederhana: input diproses secara lokal, hasilnya digunakan oleh aplikasi, dan hanya informasi yang memang diperlukan yang dikirim keluar. Pengurangan perpindahan data menurunkan jumlah titik yang dapat menjadi sasaran penyadapan, salah konfigurasi, atau penggunaan di luar tujuan awal.
Keuntungan ini relevan untuk percakapan pribadi, catatan kerja, dokumen internal, dan data sensor yang menggambarkan kebiasaan seseorang. Asisten di ponsel, misalnya, dapat mengubah rekaman suara menjadi teks secara lokal sebelum pengguna memilih apakah hasilnya hendak dibagikan. Sistem di pabrik dapat menafsirkan perintah operator tanpa mengirim seluruh percakapan ke penyedia layanan. Dalam kedua keadaan tersebut, data mentah tetap berada lebih dekat dengan sumbernya.
Namun, pemrosesan lokal bukan sinonim dari keamanan otomatis. Perangkat dapat hilang, diretas, dipasangi aplikasi berbahaya, atau menerima model yang telah dimodifikasi. Log aplikasi juga mungkin menyimpan input secara diam-diam. SLM yang berjalan di perangkat perlu dilindungi dengan enkripsi penyimpanan, pengendalian akses, penghapusan log, pembaruan model, dan pemisahan hak antara aplikasi. Jika hasil inferensi dikirim ke server untuk pemantauan, informasi yang tampak tidak sensitif dapat tetap mengungkap pola perilaku ketika dikumpulkan dalam jumlah besar.
Contohnya terlihat pada sistem bantuan teknisi lapangan. SLM di tablet dapat membaca manual yang tersimpan di perangkat dan menjawab pertanyaan tentang urutan pemeriksaan mesin. Foto kerusakan bisa dianalisis secara lokal, sedangkan hanya kode masalah dan hasil pemeriksaan yang dikirim ke pusat. Desain seperti ini mengurangi paparan dokumen perusahaan dan gambar lokasi. Akan tetapi, jika model membutuhkan manual terbaru yang belum disinkronkan, jawabannya dapat tertinggal atau keliru.
Di sinilah muncul pertukaran antara privasi, akurasi, dan pengawasan. Model lokal memberi organisasi kendali lebih besar atas data, tetapi organisasi tetap harus menentukan data apa yang diproses, berapa lama disimpan, dan bagaimana kesalahan ditangani. Pemrosesan cloud dapat menyediakan pembaruan, audit, serta kemampuan deteksi yang lebih terpusat, sementara itu juga memperluas aliran data ke luar perangkat. SLM tidak menghapus risiko; ia memindahkan sebagian risiko dari pusat data ke banyak titik edge. Jika perangkat tersebar di ribuan lokasi, menjaga konfigurasi dan versi model menjadi pekerjaan tata kelola yang tidak ringan.
SLM unggul pada tugas terarah, bukan semua pekerjaan AI
Keunggulan SLM muncul ketika tugas memiliki ruang lingkup jelas, pola input relatif teratur, dan kesalahan dapat dibatasi melalui aturan aplikasi. Model kecil tidak perlu mengetahui seluruh dunia untuk mengubah suara menjadi perintah, mengambil nama produk dari dokumen, mengelompokkan keluhan, atau memberi jawaban dari kumpulan pengetahuan tertentu. Fokus yang sempit mengurangi kebutuhan model terhadap parameter dan konteks yang besar.
Perusahaan dapat menyesuaikan SLM melalui data internal, teknik penyetelan, atau pola pengambilan dokumen yang relevan sebelum jawaban dibuat. Dalam sistem berbasis retrieval, model tidak harus menghafal semua informasi. Aplikasi mengambil bagian dokumen yang berkaitan, kemudian SLM menyusun respons berdasarkan bagian tersebut. Cara ini dapat meningkatkan keterlacakan karena pengguna dapat diarahkan kembali ke sumber yang dipakai, walaupun kualitas hasil tetap bergantung pada dokumen dan mekanisme pencarian.
Misalnya, pusat layanan sebuah perusahaan menggunakan SLM untuk membantu agen mencari prosedur pengembalian barang. Model menerima pertanyaan, mengenali maksudnya, mengambil aturan yang sesuai berdasarkan wilayah dan jenis produk, lalu menyusun jawaban singkat. Tugas ini lebih cocok untuk model lokal atau model kecil karena kosakatanya terbatas dan jawabannya dapat dibatasi oleh dokumen resmi. Jika pertanyaan berada di luar cakupan, sistem dapat meneruskannya kepada model cloud atau manusia.
Risiko muncul ketika organisasi menganggap ukuran kecil sebagai pengganti kemampuan umum. SLM masih dapat menghasilkan jawaban yang terdengar lancar tetapi keliru, terutama ketika konteks tidak lengkap, dokumen bertentangan, atau permintaan menggunakan bahasa yang tidak tercakup dalam data pelatihan. Kompresi juga dapat mengurangi ketepatan pada tugas tertentu. Pengujian harus dilakukan pada perangkat dan kondisi nyata, bukan hanya pada data uji yang bersih.
Batas lain adalah pemeliharaan pengetahuan. Informasi yang berubah seperti kebijakan, jadwal, katalog, dan aturan operasional perlu diperbarui melalui dokumen atau model baru. Jika pembaruan dilakukan tanpa validasi, sistem dapat menyebarkan kesalahan ke banyak perangkat. SLM juga tidak cocok menjadi satu-satunya pengambil keputusan untuk konteks berisiko tinggi, seperti diagnosis medis, keputusan kredit, atau pengendalian mesin yang dapat membahayakan manusia. Dalam kasus tersebut, model sebaiknya memberi bantuan yang dapat diperiksa, sementara keputusan akhir mengikuti prosedur, otorisasi, dan pengawasan yang sesuai.
Arsitektur masa depan kemungkinan berbentuk hibrida
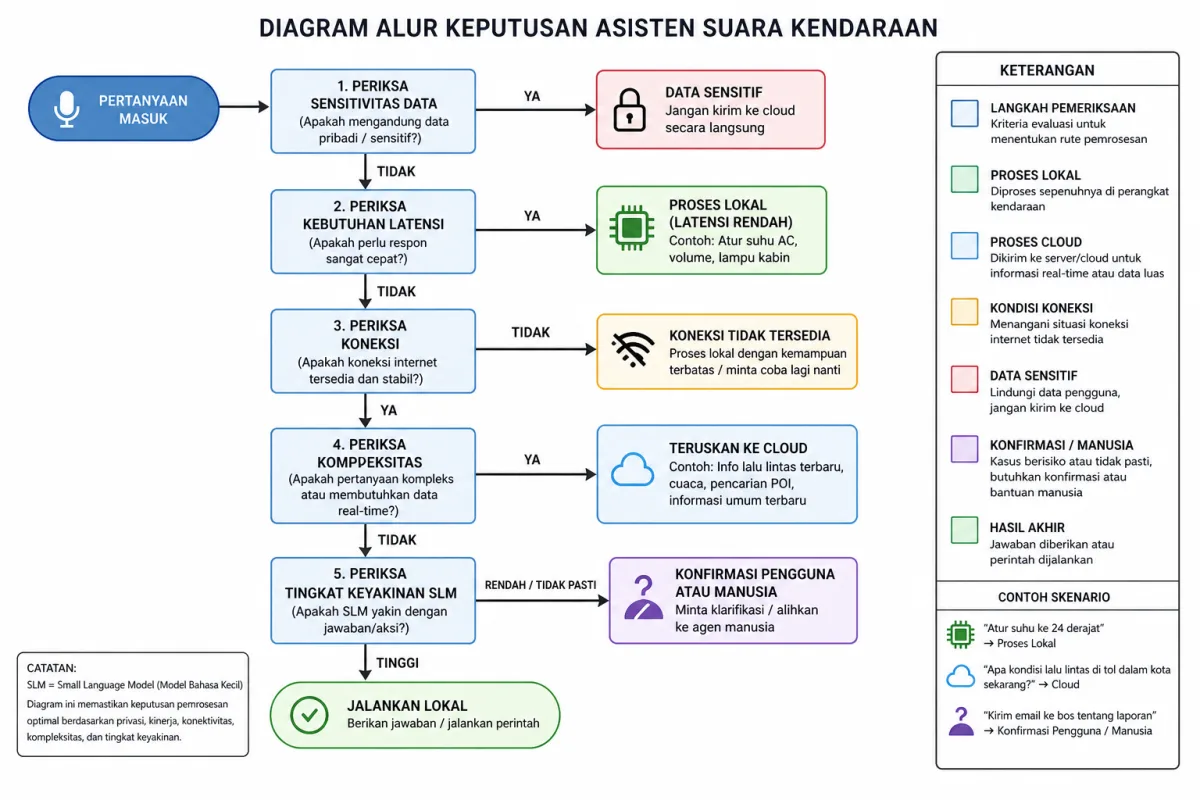
Peralihan menuju Edge AI tidak berarti setiap kemampuan harus dipindahkan ke perangkat. Arsitektur yang lebih masuk akal membagi tugas berdasarkan kebutuhan latensi, sensitivitas data, kompleksitas penalaran, dan ketersediaan jaringan. SLM menangani pekerjaan cepat dan rutin di edge, sedangkan cloud menangani permintaan yang membutuhkan konteks luas, komputasi besar, pembaruan pengetahuan, atau koordinasi lintas perangkat.
Pembagian tersebut bekerja melalui mekanisme pemilihan rute. Aplikasi dapat memeriksa panjang pertanyaan, jenis data, tingkat keyakinan model, atau kategori risiko sebelum menentukan lokasi pemrosesan. Permintaan sederhana tetap lokal. Jika SLM tidak yakin, tidak menemukan informasi yang dibutuhkan, atau mendeteksi bahwa tugas berada di luar cakupan, sistem mengirim permintaan yang telah disaring ke cloud. Hasil cloud kemudian dapat digunakan tanpa harus mengirim seluruh riwayat pengguna.
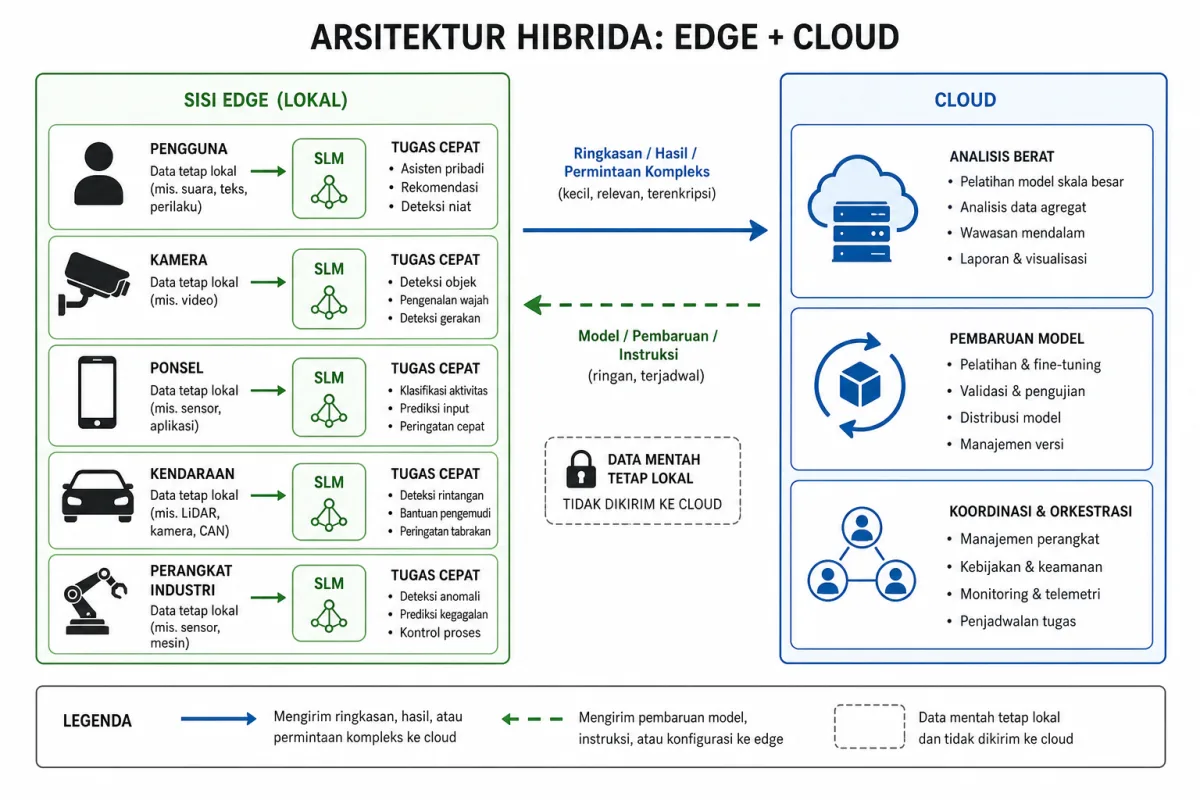
Contoh konkretnya adalah kendaraan yang memiliki asisten suara. Perintah seperti menyesuaikan suhu atau memilih tujuan yang sudah tersimpan dapat diproses di kendaraan agar respons cepat dan tetap berfungsi ketika sinyal lemah. Pertanyaan yang memerlukan informasi lalu lintas terbaru atau pencarian luas dapat diteruskan ke cloud. Dengan pembagian ini, pengalaman dasar tidak runtuh hanya karena koneksi terputus, sementara kemampuan yang lebih luas tetap tersedia saat jaringan mendukung.
Model hibrida membawa biaya dan kerumitan baru. Pengembang harus menjaga konsistensi perilaku antara model lokal dan model cloud, menentukan kapan sebuah hasil dianggap tidak meyakinkan, serta menguji berbagai kondisi jaringan. Perbedaan versi dapat membuat perangkat dan server memberi jawaban yang tidak sama. Data yang berpindah saat eskalasi juga perlu disaring agar informasi sensitif tidak ikut terkirim tanpa alasan. Selain itu, keputusan rute yang buruk dapat membuat sistem mengirim terlalu banyak permintaan ke cloud sehingga biaya dan latensi kembali meningkat.
Pilihan antara SLM, model cloud, atau kombinasi keduanya sebaiknya dimulai dari kebutuhan tugas, bukan dari tren teknologi. Ukur waktu respons, konsumsi energi, tingkat kesalahan, biaya pemeliharaan, dan dampak kegagalan. Tentukan pula apa yang terjadi ketika jaringan mati, model lokal ragu, atau data sumber belum diperbarui. Hal yang dapat dibawa pembaca dari perkembangan ini adalah prinsip sederhana: letakkan pemrosesan dekat pengguna ketika tugasnya rutin, sensitif, dan membutuhkan respons cepat; gunakan cloud ketika keluasan konteks dan daya komputasi lebih menentukan. SLM bukan pengganti universal, melainkan salah satu lapisan dalam sistem AI yang lebih terdistribusi.
Lely
AdminDIPON STARTER.